Les termes "scanner de cookies" et "détection automatique" sont souvent utilisés dans les fonctionnalités des CMP. Ils peuvent donner l’impression de désigner deux variantes de la même chose.
Ce n’est pas vraiment le cas. Un scanner sert principalement à observer un site et à établir un inventaire. Une détection automatique comme celle utilisée par tarteaucitron Pro intervient pendant le chargement de la page afin de reconnaître un service et de pouvoir agir avant qu’il ne fonctionne.
Les deux approches peuvent être utiles, mais elles ne résolvent pas le même problème.
À quoi sert un scanner de cookies ?
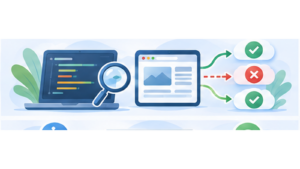
Un scanner parcourt généralement les pages d’un site comme le ferait un navigateur automatisé. Il observe les cookies, scripts et autres technologies rencontrés puis construit un inventaire.
Selon la solution, les éléments détectés peuvent être classés automatiquement par catégorie, associés à un fournisseur ou intégrés à une déclaration de cookies.
C’est particulièrement utile pour découvrir ce qui existe sur un site que l’on connaît mal.
Une entreprise peut par exemple découvrir qu’un plugin WordPress charge un service externe qui n’avait jamais été identifié lors de la mise en place initiale de la CMP.
Un scan est une photographie du site
La principale limite vient de la nature même du scan. Le scanner ne peut observer que ce qu’il rencontre pendant son exploration.
Un service chargé uniquement sur la page de confirmation d’une commande, après la connexion d’un utilisateur ou à la suite d’une interaction particulière peut ne jamais apparaître pendant le scan.
Il en va de même pour les scripts déclenchés selon une condition spécifique, une campagne marketing ou une configuration de Google Tag Manager.
Un scanner fournit donc un inventaire extrêmement utile, mais cet inventaire dépend nécessairement des pages et scénarios qu’il a réellement parcourus.
Détecter automatiquement pendant le chargement répond à un autre problème
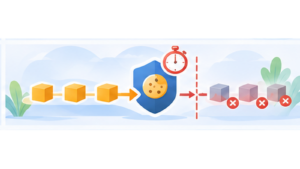
La détection automatique de tarteaucitron Pro intervient directement dans la page visitée.
Le JavaScript observe les éléments qui tentent de se charger et reconnaît des services supportés à partir de règles connues. Il peut par exemple identifier certaines URL ou ressources appartenant à Google Analytics, Facebook, YouTube ou d’autres services intégrés à tarteaucitron.
Lorsque tarteaucitron est chargé suffisamment tôt, cette détection permet d’intervenir avant le chargement effectif du service concerné.
Le but n’est donc pas seulement de répondre à la question "qu’est-ce qui existe sur ce site ?", mais à la question "qu’est-ce qui essaie de se charger maintenant sur cette page ?".
Détecter un service n’est pas simplement détecter un cookie
Le terme "scanner de cookies" est lui-même un peu réducteur. Le problème du consentement ne se limite pas aux petits fichiers stockés dans le navigateur.
Un service tiers peut envoyer des données dès le chargement d’un script ou d’une iframe, avant même que l’on s’intéresse aux cookies qu’il déposera ensuite.
Pour une CMP, il est donc souvent plus important d’identifier le service et d’empêcher sa requête initiale que d’attendre qu’un cookie apparaisse pour constater son existence.
La réglementation sur les traceurs ne se limite d’ailleurs pas aux cookies. La CNIL parle plus largement de cookies et autres traceurs.
Un scanner ne bloque pas nécessairement ce qu’il trouve
C’est une distinction particulièrement importante lorsque l’on compare des CMP.
Une solution peut parfaitement produire un excellent rapport indiquant que Google Analytics, Meta Pixel et différents cookies sont présents sur un site. Cela ne signifie pas automatiquement qu’elle empêche ces technologies de fonctionner avant consentement.
L’inventaire est une étape. Le blocage en est une autre.
Après avoir installé une CMP, je recommande donc toujours de vérifier directement les requêtes réseau avec les DevTools.
La détection automatique n’est pas magique non plus
La situation inverse mérite la même prudence. Une CMP qui propose une détection automatique ne peut pas reconnaître arbitrairement tous les scripts existant sur Internet.
Elle fonctionne à partir de règles permettant d’identifier les services qu’elle connaît.
Avec tarteaucitron, la liste des services et les règles de détection sont donc maintenues au fil du temps. Lorsqu’un fournisseur change son intégration, ses domaines ou son fonctionnement, ces règles peuvent devoir évoluer.
Un service inconnu ou une intégration très particulière peut ne pas être détecté automatiquement.
L’ordre de chargement reste déterminant
Même la meilleure règle de détection ne peut pas remonter dans le temps.
Si Google Analytics a déjà exécuté son JavaScript et envoyé une requête avant que la CMP soit chargée, détecter ensuite sa présence ne permet pas d’annuler cette requête.
C’est pourquoi le marqueur tarteaucitron Pro doit être placé aussi haut que possible dans le <head>, avant les services qu’il doit contrôler.
J’ai consacré un article entier à l’importance de l’ordre de chargement, parce que cette règle simple explique une grande partie des intégrations incorrectes.
Le mode manuel évite lui aussi d’avoir besoin d’un scanner
Dans tarteaucitron open source, l’approche est encore différente.
Le développeur sait normalement quels services il installe. Il retire par exemple la balise GA4 directement présente dans le site puis déclare le service GA4 à tarteaucitron.
La CMP devient alors le point de passage pour charger le service après consentement.
Cette méthode demande davantage de travail, mais elle est très explicite : il n’est pas nécessaire de découvrir automatiquement un script que l’on vient soi-même de déclarer.
Le scanner reste très utile pour les sites complexes
Je ne considère donc pas les scanners comme inutiles. Sur un site ancien, une installation WordPress comportant de nombreuses extensions ou un projet auquel plusieurs prestataires ont contribué, un inventaire automatisé peut faire apparaître des surprises.
Il peut également servir d’outil de contrôle régulier. Si un nouveau tracker apparaît après une mise à jour ou une intervention marketing, le scan peut aider à le repérer.
Ce n’est simplement pas la même fonction qu’un mécanisme chargé d’empêcher ce tracker de partir avant consentement.
Scanner, détecter, bloquer et vérifier
Je distinguerais donc quatre opérations.
- Scanner permet d’établir un inventaire des technologies rencontrées sur le site.
- Détecter permet d’identifier un service lorsqu’il apparaît dans la page.
- Bloquer permet d’empêcher ce service de fonctionner tant que les conditions nécessaires ne sont pas remplies.
- Vérifier permet de confirmer dans le navigateur que le résultat attendu est réellement obtenu.
Une CMP peut combiner plusieurs de ces fonctions, mais les présenter sous un seul terme "détection automatique" entretient facilement la confusion.
Le meilleur outil dépend surtout du site
Pour un site simple dont le développeur connaît parfaitement les cinq services externes utilisés, un scanner permanent n’est pas nécessairement indispensable.
Pour un grand site qui évolue régulièrement, un scan peut apporter une visibilité très utile.
Dans les deux cas, le problème final reste le même : une fois le service identifié, il faut encore s’assurer qu’il respecte réellement le choix du visiteur.
Un inventaire parfait qui liste un tracker déjà exécuté avant le consentement reste seulement un très bon inventaire d’un problème.